
Tiyat, el primer modelo de IA en Lenguas Originarias de México
Presentamos Tiyat, el primer modelo de Inteligencia Artificial fundacional tipo LLM-nano entrenado desde cero con una representación mayoritaria de lenguas originarias de México. Hasta donde sabemos, este es el primer modelo de LLM desarrollado específicamente para las lenguas originarias de México con el ambicioso objetivo de soportar las 68 lenguas y sus 364 variantes.
Su desarrollo reúne años de investigación e importantes avances previos de Tachiwin: digitalización de documentos, clasificación, construcción de un corpus multilingüe, entrenamiento de un tokenizador propio y el entrenamiento de un modelo fundacional partiendo desde cero.
Tiyat, sin embargo es un trabajo incipiente, aún está muy lejos de un modelo de IA frontera, actualmente puede recibir el inicio de un texto y generar una continuación breve. No es todavía un modelo de chat ni sigue instrucciones complejas: su funcionamiento se parece más al autocompletado de los primeros modelos GPT y a los experimentos de modelos pequeños entrenados con narraciones. En las pruebas iniciales produce segmentos con estructuras reconocibles, distingue patrones entre lenguas y puede conservar durante algunos tokens la lengua y el estilo de un prompt.
¿Qué significa Tiyat? Tiyat es una palabra en Tutunakú que significa tierra o suelo. El nombre hace referencia a que este LLM fue entrenado desde cero y sirve como base para desarrollar modelos posteriores. Es el primer brote de esta línea de investigación de Tachiwin.
Tiyat en cifras
| Característica | Tiyat arch1 |
|---|---|
| Tipo de modelo | Transformer decoder-only |
| Parámetros | ~180 millones |
| Datos de entrenamiento | ~300 millones de tokens |
| Vocabulario | 64 mil tokens |
| Bloques Transformer | 12 |
| Dimensión de embeddings | 768 |
| Cabezas de atención | 24 |
| Dimensión feed-forward | 3072 |
| Ventana de contexto | 918 tokens |
| Embeddings de entrada y salida | Independientes |
| Objetivo | Predicción del siguiente token |
Tiyat es un modelo nano: tiene un tamaño del mismo orden que los primeros modelos GPT-2 y es miles de veces menor que los modelos comerciales actuales. Esa escala permite estudiar el proceso completo, repetir experimentos y detectar problemas antes de avanzar hacia modelos más grandes. Su objetivo inmediato no es competir con un modelo frontera, sino demostrar que es posible entrenar desde cero una arquitectura generativa donde las lenguas originarias ocupen la mayor parte del corpus y que además este desarrollo está al alcance de toda persona que desee replicarlo ya que todos sus procesos y conocimiento son totalmente libres y open-source.
¿Por qué entrenar un modelo desde cero?
Una distribución digital profundamente desigual
Los modelos de lenguaje actuales se entrenan con colecciones que pueden alcanzar billones o trillones de tokens. Buena parte procede de rastreos automatizados de la web, complementados con libros digitalizados, código, publicaciones académicas y repositorios gubernamentales. El resultado refleja la distribución del contenido disponible: en muchos corpus, el inglés puede ocupar entre 90% y 95% del texto y otro porcentaje importante corresponde a lenguas europeas de alta presencia digital.
Esa exposición es suficiente para que un modelo desarrolle representaciones internas útiles del inglés y, con proporciones mucho menores pero todavía abundantes, de lenguas como el español. Las lenguas originarias de México también pueden aparecer de manera incidental, pero su volumen es decenas de miles o millones de veces menor. Un modelo general puede reconocer términos frecuentes o reproducir expresiones aisladas sin haber recibido suficiente información para representar de forma consistente sus estructuras.
México reconoce 68 lenguas originarias nacionales, con aproximadamente 360 variantes pertenecientes a 11 familias lingüísticas. Incluso reuniendo décadas de publicaciones y los materiales disponibles libremente en internet, el volumen obtenible se acerca más al equivalente de miles de libros que a las decenas de millones utilizadas por un modelo frontera. El problema no es la riqueza de las lenguas, sino su escasa representación en formatos digitales procesables.
Por qué no bastaba con adaptar un modelo existente
Tachiwin ya había trabajado con preentrenamiento y ajuste fino de modelos existentes para traducción. Ese camino sigue siendo útil, pero plantea tres dificultades para este experimento:
- Representación insuficiente. Los pesos de partida fueron aprendidos principalmente a partir de otras lenguas.
- Tokenización desigual. El vocabulario de esos modelos fragmenta con mayor intensidad muchas palabras de lenguas con pocos recursos digitales.
- Incompatibilidad de vocabulario. Sustituir el tokenizador cambia la relación entre cada identificador y su embedding; no es posible conservar sin más las capas de entrada y salida del modelo original.
Además, el corpus de Tachiwin todavía es pequeño para reentrenar por completo un modelo frontera. Paradójicamente, para estudiar este conjunto de lenguas resultaba más directo comenzar con un modelo pequeño y pesos aleatorios. Al inicio del entrenamiento, Tiyat no contiene una representación heredada del inglés ni de otra lengua: sus regularidades se forman a partir de la mezcla de datos definida para el proyecto.
Un solo modelo para la diversidad lingüística de México
Muchos proyectos de tecnología lingüística comienzan con una sola lengua o con un grupo estrechamente relacionado. Tachiwin también inició su trabajo desde el Tutunakú de la Sierra Norte (tos), donde se concentra una parte importante de nuestra experiencia. Sin embargo, los materiales que encontramos rara vez estaban organizados de ese modo.
Leyes, comunicados, colecciones educativas y repositorios públicos suelen reunir numerosas lenguas. Algunos documentos incluyen varias dentro del mismo archivo. Separar una sola lengua implicaba desarrollar primero sistemas de clasificación, revisar manualmente materiales y desechar textos útiles de otras comunidades.
Decidimos invertir el planteamiento: incluir todas las lenguas originarias de México que pudiéramos documentar y estudiar si un único modelo pequeño podía aprender patrones de esa diversidad. Modelos y corpus multilingües conocidos suelen concentrarse en decenas de lenguas o alrededor de un centenar; Tiyat persigue cobertura sobre aproximadamente 360 variantes dentro de una sola arquitectura. Esta amplitud aumenta la dificultad de evaluación, pero evita reducir el proyecto a una única lengua de partida.
Primer componente: digitalizar los textos
El corpus no estaba listo para entrenar
Existe una producción extensa y diversa en lenguas originarias de México: cuentos, canciones, leyendas, materiales educativos, vocabularios, textos religiosos, documentos legales, investigaciones académicas, comunicados y contenidos científicos. Gobiernos, instituciones, autoras, autores y comunidades han producido y preservado estos materiales durante décadas.
Una proporción importante no está disponible como texto plano. Se encuentra en libros impresos, fotografías o archivos PDF que solo contienen imágenes escaneadas. Aunque una persona pueda leerlos, un modelo de lenguaje necesita recibir caracteres digitales en archivos estructurados. El rastreo de páginas web, por sí solo, no podía producir el volumen necesario.
Tachiwin OCR 1.5 como parte de la canalización
Para resolver este cuello de botella desarrollamos Tachiwin OCR 1.5, un modelo capaz de extraer texto y reconocer grafías, diacríticos, glotales, tonos marcados y otras particularidades que suelen generar errores en sistemas de OCR generales.
La canalización quedó organizada en cuatro pasos:
- localizar documentos y revisar sus condiciones de uso;
- convertir páginas y escaneos en imágenes procesables;
- extraer el texto con Tachiwin OCR;
- revisar, normalizar y preparar los resultados para el corpus.
El OCR permitió incorporar materiales que no habrían aparecido en una recolección convencional de la web. También amplió la diversidad de géneros: el corpus no contiene solamente páginas recientes de internet, sino publicaciones educativas, culturales, administrativas y académicas.
Segundo componente: entrenar un tokenizador propio
La desventaja oculta en la fragmentación
Un tokenizador analiza y divide el texto en unidades que el modelo puede procesar. Estas unidades, llamadas tokens, pueden parecerse a palabras, sílabas, partes de palabras, caracteres o signos. El tokenizador busca combinaciones útiles y frecuentes en los textos con los que fue entrenado, de manera similar a encontrar las piezas más convenientes para descomponer y reconstruir una lengua.
Los tokens son las unidades básicas de procesamiento de un LLM. Cuanto mejor se adapte el tokenizador a un grupo de lenguas, menos piezas innecesarias necesita el modelo y más eficientemente puede leer y generar sus textos. La forma de dividirlos determina:
- cuánto texto cabe en la ventana de contexto, es decir, cuánto puede considerar el modelo al producir la continuación;
- cuántos pasos necesita para generar una oración completa, porque el modelo produce un token a la vez;
- con qué eficiencia convierte fragmentos de texto en representaciones internas, al asignar significado y relaciones a unidades más informativas;
- cuánto cálculo requiere leer y producir un mismo fragmento, ya que una división excesiva multiplica las operaciones necesarias.
Un tokenizador moderno puede representar cualquier secuencia Unicode, pero eso no significa que lo haga con la misma eficiencia en todas las lenguas. Cuando fue entrenado principalmente con inglés, suele disponer de tokens completos para patrones frecuentes en esa lengua y dividir en muchas piezas las secuencias que casi no aparecieron en sus datos.
La diferencia se puede medir con la fertilidad —el número promedio de tokens necesario por palabra— o con su lectura inversa aproximada, los caracteres representados por token. En nuestras pruebas preliminares, el inglés se acercaba a 4.4 caracteres por token y el español a 4.1, mientras que algunas lenguas originarias podían aproximarse a 1.1 o incluso menos. En esos casos, un mismo límite de contexto contiene mucho menos texto y la generación requiere más operaciones.
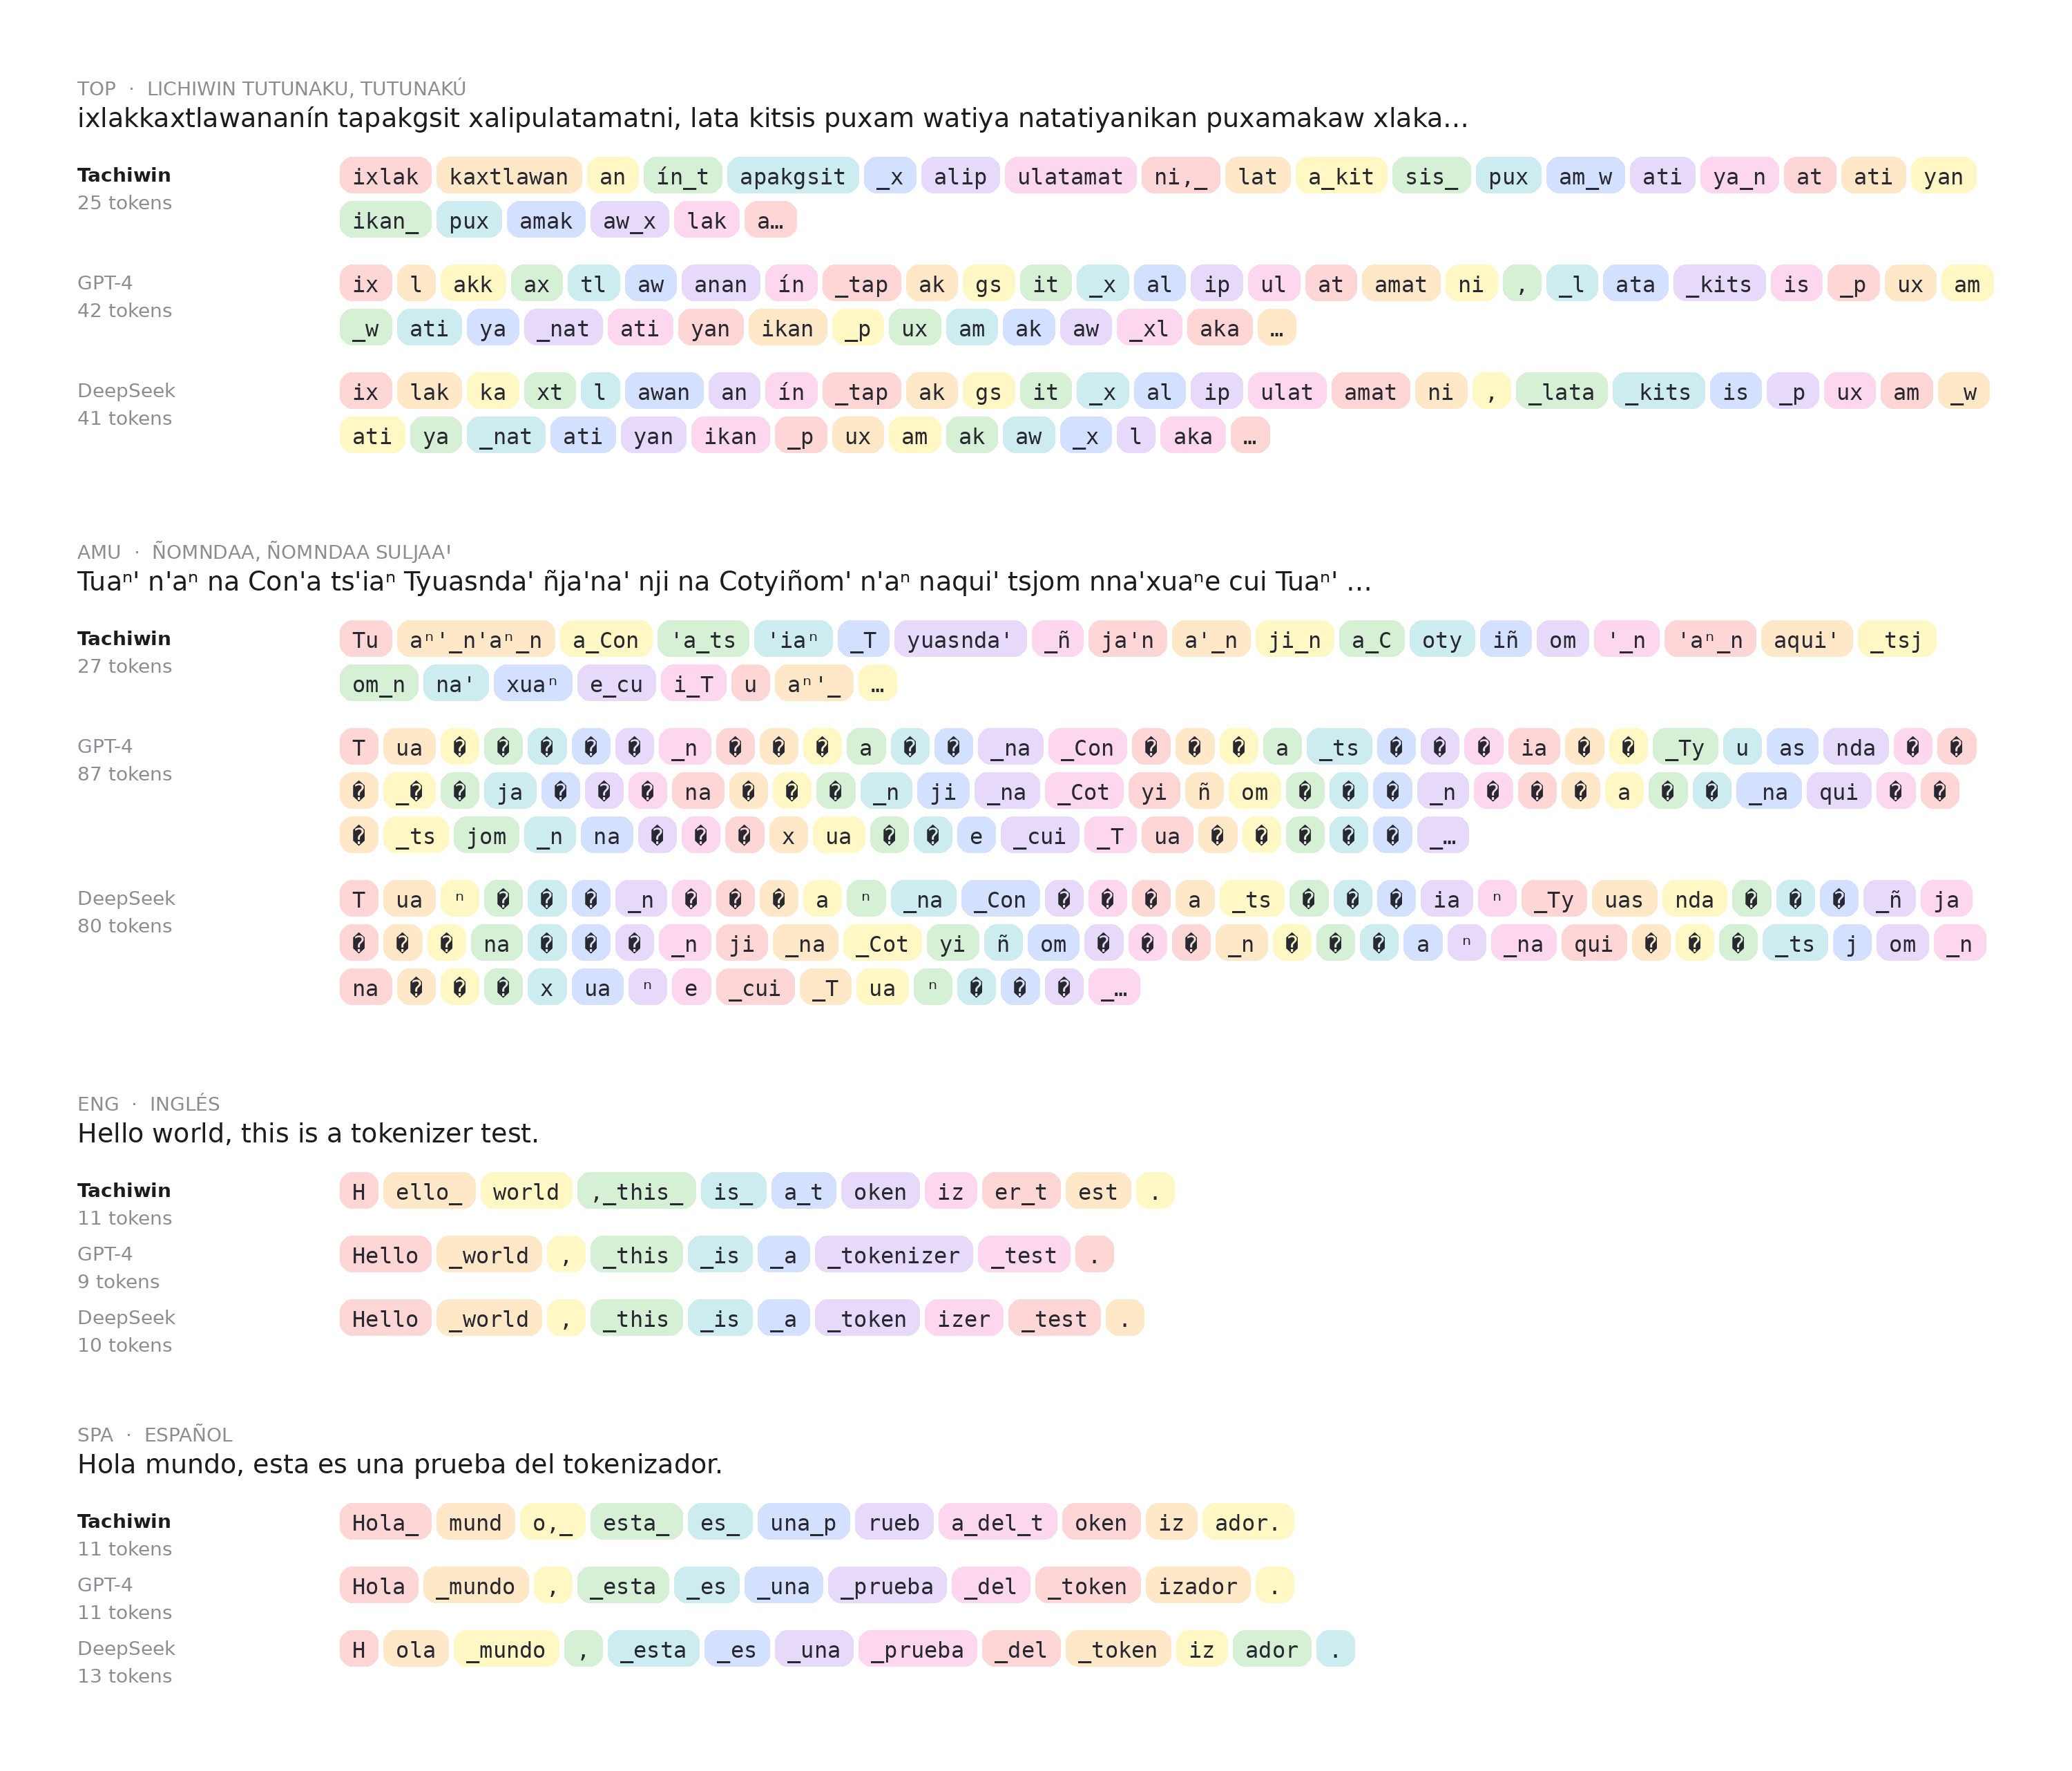
Comparación de cómo los tokenizadores de Tachiwin, GPT-4 y DeepSeek dividen ejemplos en Tutunakú, Ñomndaa, inglés y español. En las dos lenguas originarias mostradas, el tokenizador de Tachiwin representa el mismo texto con muchas menos unidades —un menor número de tokens implica un procesamiento más eficiente—; en inglés y español mantiene un conteo comparable con los tokenizadores generalistas.
Vocabularios de 64K y 128K
Después de ampliar el corpus entrenamos dos tokenizadores, de 64 mil y 128 mil unidades. Evitamos un presegmentado rígido mediante expresiones regulares diseñadas para el inglés: aunque esas reglas aceleran la construcción de vocabularios convencionales, también introducen supuestos sobre espacios, contracciones y límites de palabra que no queríamos fijar de antemano.
Tiyat arch1 utiliza el tokenizador de 64K. El vocabulario es mayor que el de GPT-2 y fue aprendido sobre la distribución multilingüe del corpus de Tachiwin. Esto no garantiza una eficiencia idéntica para cada variante —sus volúmenes siguen siendo desiguales—, pero reduce la dependencia de unidades construidas casi exclusivamente desde el inglés.
Tercer componente: el modelo de lenguaje
Una arquitectura comparable con los primeros GPT-2
Tiyat utiliza una arquitectura Transformer decoder-only. Recibe una secuencia y aprende a predecir el token siguiente sin observar posiciones futuras. Sus aproximadamente 180 millones de parámetros se distribuyen entre embeddings de tokens y posiciones, 12 bloques de atención y capas feed-forward, normalizaciones y una proyección final sobre el vocabulario.
La escala es comparable con modelos pequeños de la generación GPT-2, aunque la arquitectura y el vocabulario no son idénticos. Tiyat comienza con pesos aleatorios y emplea 64 mil tokens frente al vocabulario de aproximadamente 50 mil de GPT-2. La canalización incluye atención causal, normalización previa, activación GELU, conexiones residuales y dropout.
El entrenamiento utiliza AdamW, recorte de gradientes, calentamiento y decaimiento de la tasa de aprendizaje. También excluye los tokens de relleno del cálculo de pérdida y conserva checkpoints con el estado del modelo, el optimizador y la posición exacta en los datos. Estas decisiones permiten reanudar ejecuciones largas sin repetir el inicio del corpus.
Entrenamiento accesible y reproducible
Tiyat fue entrenado pacientemente a lo largo de varias sesiones en el nivel gratuito de Google Colab, utilizando una GPU NVIDIA T4 con 16 GB de memoria. Elegimos deliberadamente este entorno para incentivar la replicación y demostrar que entrenar un LLM pequeño desde cero no tiene que ser una actividad reservada a grandes empresas o laboratorios con infraestructura especializada.
Los checkpoints permitieron continuar cada sesión desde el punto donde terminaba la anterior. Con tiempo y paciencia, una persona puede repetir el proceso usando recursos al alcance de cualquier usuario, sin comprar una GPU propia y con un costo económico prácticamente nulo, sujeto a la disponibilidad de recursos gratuitos de la plataforma. El tamaño de Tiyat responde también a este objetivo: mantener el entrenamiento comprensible, modificable y reproducible con hardware de grado de consumo.
Relación con TinyStories
Tiyat guarda cierto parecido con los experimentos TinyStories, que demostraron que modelos pequeños pueden aprender a continuar narraciones sencillas cuando se entrenan con historias breves y estructuras recurrentes. Una parte del corpus de lenguas originarias incluye cuentos, canciones, leyendas y materiales dirigidos a la infancia o a la enseñanza.
La comparación, sin embargo, es parcial. TinyStories se concentra en narraciones sintéticas en inglés. El corpus de Tiyat es multilingüe y añade textos religiosos, legales, administrativos, académicos, científicos y código. Esto aporta una mayor diversidad de registros, pero también exige que una capacidad limitada se distribuya entre muchas lenguas, variantes y dominios.
Composición del corpus
Representación deliberada, no incidental
Agregar el corpus de Tachiwin a una mezcla convencional habría reducido nuevamente las lenguas originarias a una fracción mínima frente al inglés. Por eso definimos una distribución propia:
| Categoría | Proporción objetivo |
|---|---|
| Lenguas originarias de México | 70% |
| Español | 7.5% |
| Inglés | 7.5% |
| Código | 15% |
El español y el inglés aportan conexiones con recursos abundantes y el código añade estructuras formales. La diferencia principal está en el 70% reservado para lenguas originarias: no se incorporan como una ampliación marginal, sino como el componente predominante.
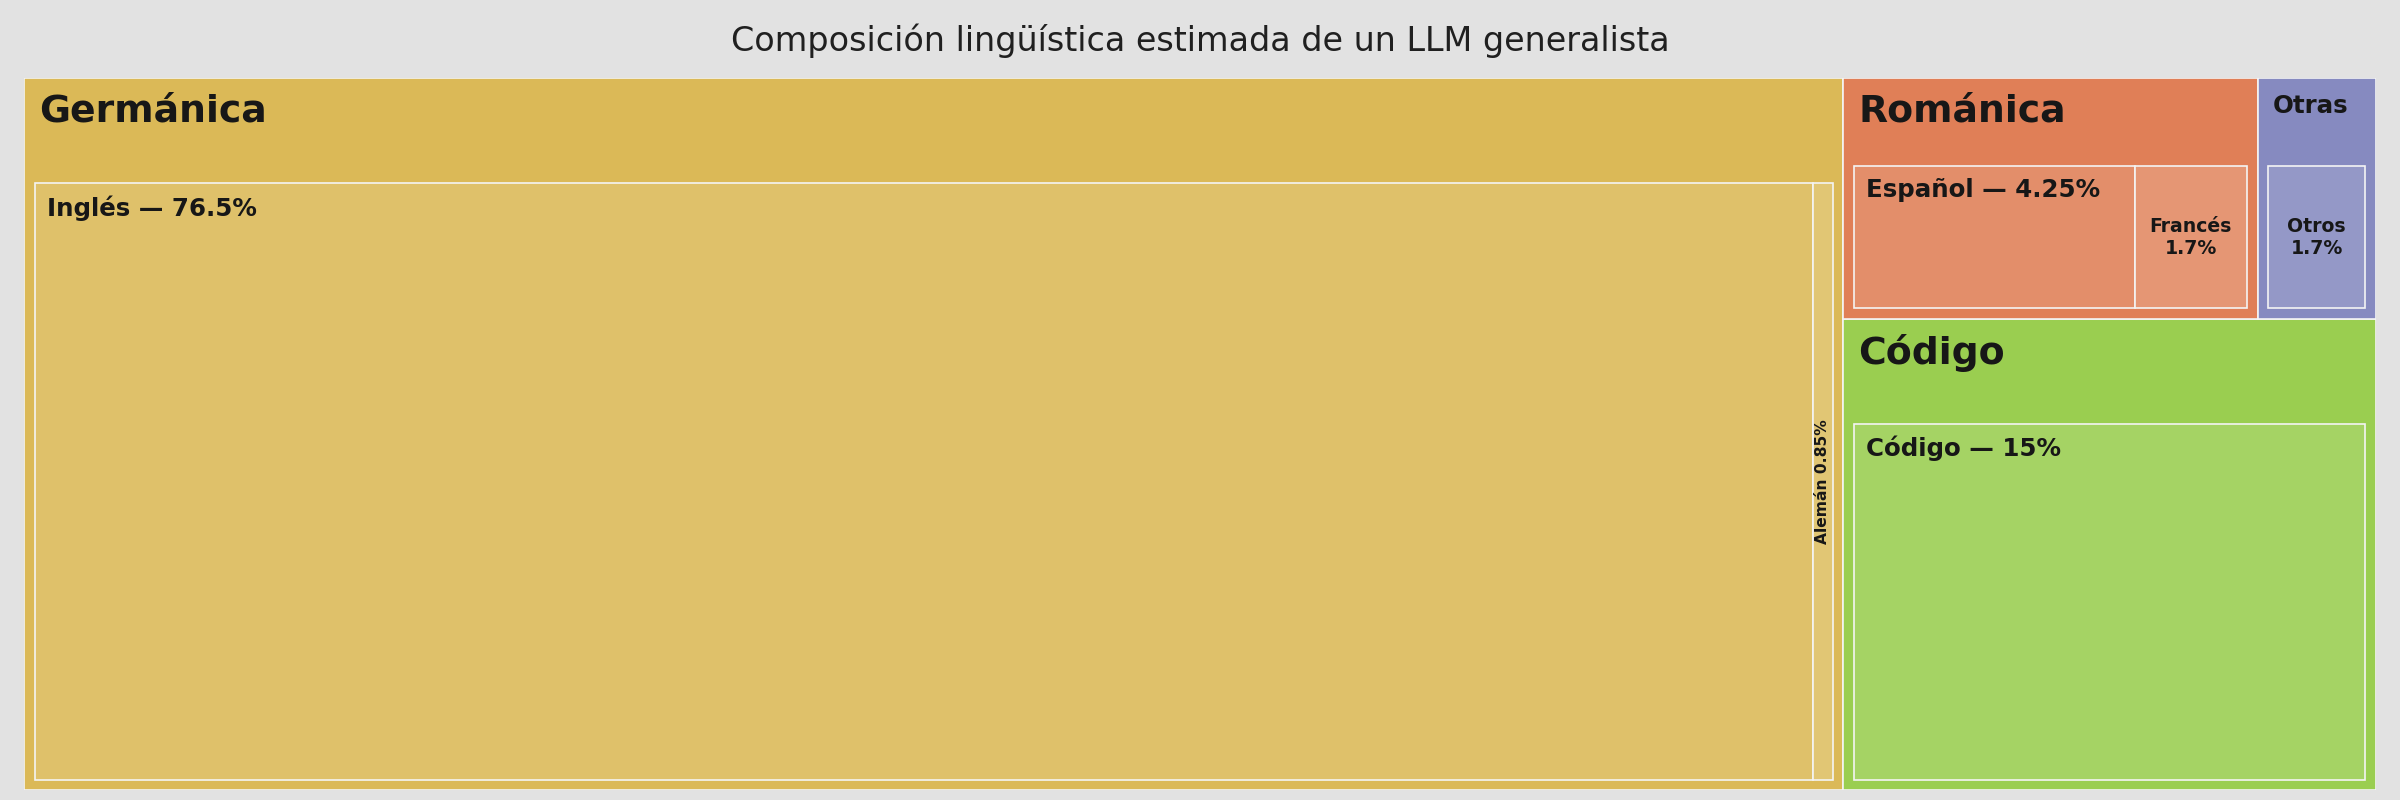
Composición lingüística estimada de un corpus generalista: el inglés ocupa la mayor parte del entrenamiento, mientras que el español y las demás lenguas reciben proporciones mucho menores.
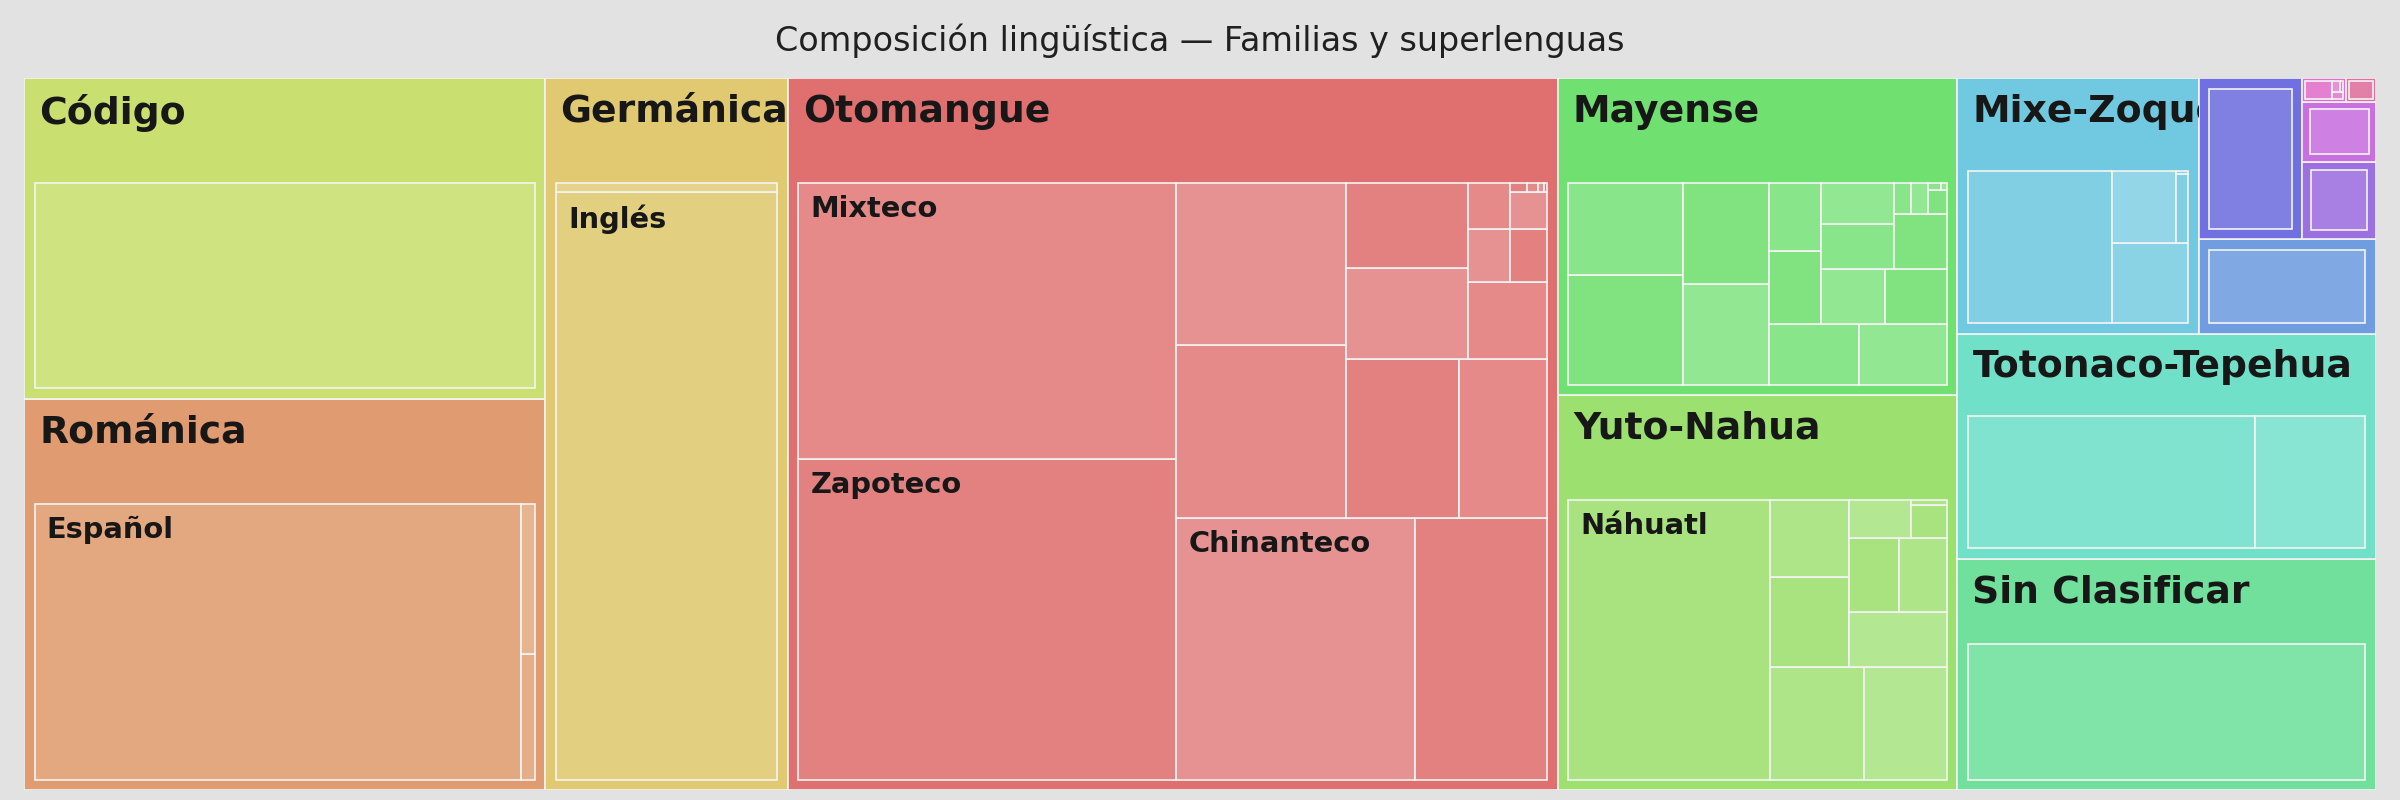
Composición del corpus de Tiyat por familias y agrupaciones lingüísticas. El área de cada bloque representa su proporción dentro del conjunto de entrenamiento y hace visible el contraste con la distribución habitual de un LLM generalista.
Diversidad, calidad y mezcla de dominios
El preentrenamiento autoregresivo puede aprovechar texto de numerosas fuentes sin requerir que cada documento corresponda a una sola tarea o tema. Esta propiedad hizo posible conservar documentos multilingües y combinar géneros que otros sistemas de procesamiento lingüístico tratarían por separado.
Eso no vuelve innecesaria la preparación de datos. El OCR introduce errores; algunos documentos repiten fórmulas; las etiquetas de lengua pueden ser incompletas y la representación entre variantes es desigual. La canalización debe equilibrar diversidad, calidad, procedencia y volumen sin exigir una pureza que eliminaría gran parte de los materiales disponibles.
También queremos estudiar una pregunta más amplia: si los corpus dominados por inglés introducen una perspectiva cultural igualmente dominante en sus representaciones, ¿qué cambia cuando las lenguas originarias ocupan la mayor parte de la mezcla? Tiyat todavía no permite responderlo. Su función es proporcionar una base experimental para formular y medir esa pregunta en versiones posteriores.
Decisiones técnicas derivadas de los datos
Embeddings de entrada y salida independientes
Muchos modelos pequeños comparten la matriz que representa tokens de entrada con la matriz utilizada para puntuarlos a la salida. Esto reduce parámetros y, en distintos modelos, puede mejorar el aprendizaje. En nuestros experimentos, ligar ambas matrices produjo peores resultados.
Tiyat arch1 mantiene matrices independientes. Nuestra hipótesis es que la diversidad lingüística y ortográfica exige funciones diferentes para representar un token dentro del contexto y para seleccionarlo como salida, pero esta explicación todavía debe comprobarse mediante ablaciones controladas.
Una ventana de 918 tokens
La ventana de contexto no es una potencia de dos. El valor de 918 tokens se obtuvo al analizar la distribución de longitud de los ejemplos tokenizados. Elegir 1024 habría aumentado memoria y cálculo sin aprovechar de manera proporcional el corpus; escoger una ventana menor habría recortado información escasa.
La decisión ilustra el criterio general de Tiyat: adaptar la arquitectura a los datos disponibles en lugar de copiar automáticamente las dimensiones habituales de modelos entrenados con corpus diferentes.
Datos por parámetro y margen de crecimiento
Tiyat fue entrenado con alrededor de 300 millones de tokens para aproximadamente 180 millones de parámetros: menos de dos tokens por parámetro. Las reglas de escalamiento conocidas como Chinchilla suelen utilizar como referencia alrededor de 20 tokens por parámetro, aunque esa relación no debe interpretarse como una ley exacta para todas las mezclas y lenguas.
La diferencia indica que Tiyat está limitado principalmente por los datos, no que haya agotado la capacidad de su arquitectura. El mismo modelo todavía puede beneficiarse de varias rondas adicionales de digitalización y entrenamiento antes de que sea necesario aumentar considerablemente su tamaño.
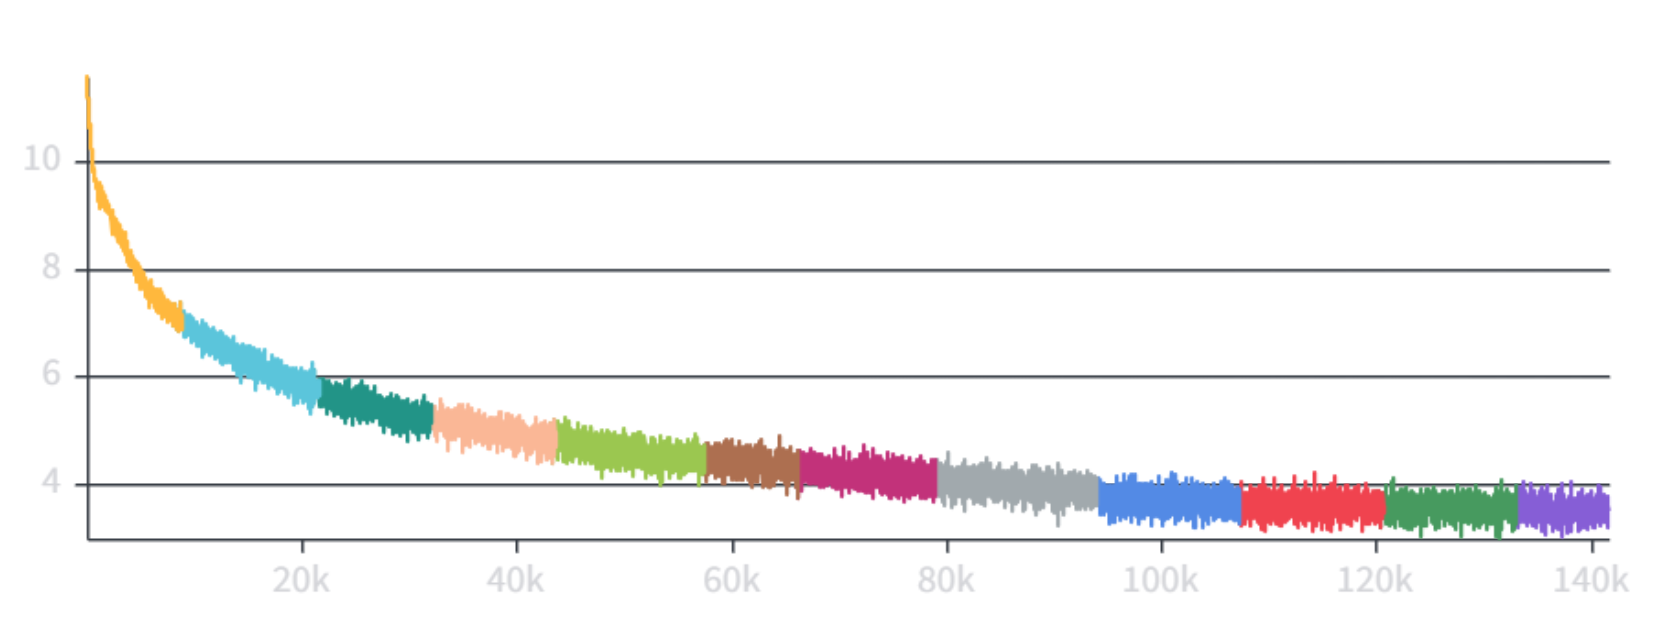
Pérdida de entrenamiento de Tiyat a lo largo de aproximadamente 140 mil pasos. Los distintos colores corresponden a las sesiones sucesivas recuperadas desde checkpoints; la tendencia descendente muestra que el modelo continuó aprendiendo durante todo el proceso.
Capacidades y límites actuales
Qué observamos en las primeras generaciones
Las pruebas iniciales indican que Tiyat puede:
- diferenciar patrones de distintas lenguas;
- continuar prompts breves en la lengua identificada;
- producir segmentos con estructuras gramaticales reconocibles;
- mantener una narrativa sencilla durante parte de la generación;
- aprovechar prompts más largos para inferir mejor la lengua y el registro.
Estos resultados son relevantes porque un modelo de este tamaño distribuye su capacidad entre aproximadamente 360 variantes. Algunos autores han cuestionado que modelos muy pequeños puedan aprender más de una lengua de forma útil; Tiyat ofrece un caso experimental para examinar esa hipótesis bajo una mezcla fuertemente multilingüe.
Cómo conviene probarlo
Tiyat es un modelo base de autocompletado, no un asistente conversacional. Funciona mejor cuando el prompt inicia la clase de texto que se espera continuar:
Había una vez un gato que...
Un prompt de varias palabras aporta señales sobre lengua, variante, tema y estilo. Con entradas demasiado cortas, la predicción es más inestable y puede mezclar lenguas emparentadas o producir un pastiche de variantes. Tiyat tampoco ha recibido una etapa de ajuste para seguir instrucciones, por lo que una pregunta directa no activa necesariamente una respuesta pertinente.
Tachiwin es un proyecto abierto y un laboratorio pequeño, por lo que no contamos con un servicio dedicado y permanente como ChatGPT. Sin embargo, Hugging Face y ModelScope nos permiten ofrecer demostraciones públicas donde cualquier persona puede probar Tiyat sin costo. Estos servicios pueden tardar en iniciar o entrar en pausa cuando no se utilizan, pero permiten experimentar con el modelo sin instalarlo ni disponer de una GPU propia.
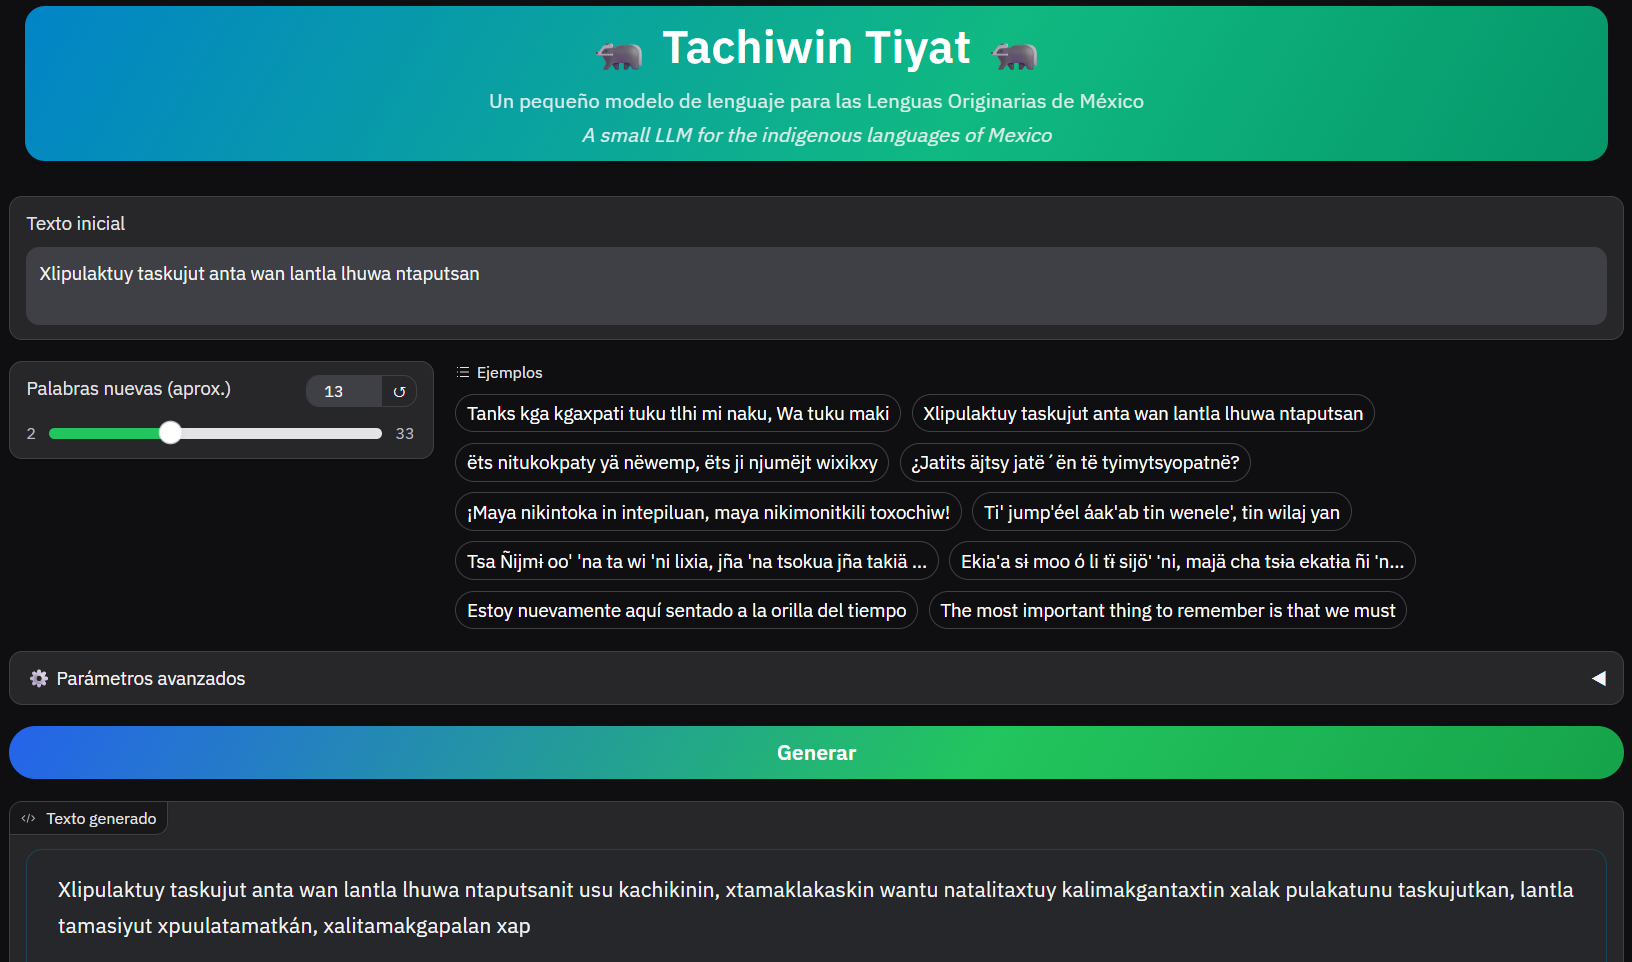
Interfaz pública de Tiyat Nano: permite introducir un texto inicial, elegir la longitud aproximada de la continuación, utilizar ejemplos en distintas lenguas y modificar parámetros avanzados de generación.
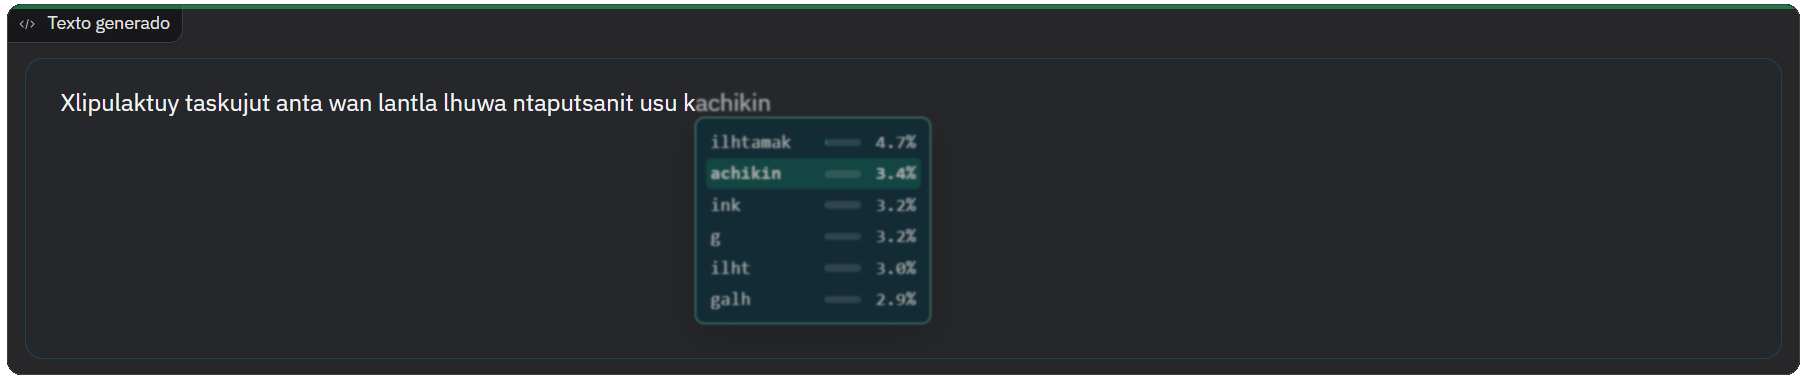
Visualización de una inferencia en Tutunakú. Los tokens aparecen conforme el modelo genera la continuación; al colocar el cursor sobre uno de ellos se muestran otras alternativas consideradas a partir de los logits y sus probabilidades relativas.
Fallos conocidos y evaluación pendiente
En generaciones extensas, el modelo puede perder coherencia, repetir frases o recuperar tramos similares a textos muy frecuentes. Entre los casos observados se encuentran fragmentos de la Constitución mexicana y de la Biblia, dos tipos de contenido con fórmulas y repeticiones abundantes dentro de algunas colecciones.
La evaluación es especialmente compleja. No basta con una puntuación global para 68 lenguas y cientos de variantes: necesitamos pruebas por lengua, familia, dominio y tipo de capacidad, además de revisión por hablantes. Los resultados actuales deben entenderse como observaciones del comportamiento, no como una evaluación lingüística definitiva.
Dos ideas frecuentes sobre la IA que requieren contexto
“Los modelos guardan una copia de todos los textos”
Un modelo de lenguaje no funciona como una base de datos que almacena cada documento para recuperarlo literalmente. Durante el entrenamiento ajusta parámetros para reducir el error al predecir el siguiente token; el archivo final es mucho menor que el conjunto completo de textos procesados.
Esto no significa que la memorización sea imposible. Fragmentos muy repetidos, fórmulas o secuencias distintivas pueden reaparecer en una generación. Por esa razón son importantes la procedencia de los datos, sus permisos y licencias, el control de duplicados y las pruebas de memorización. La publicación abierta del modelo tampoco sustituye estas responsabilidades.
“Toda IA consume enormes cantidades de agua”
Los modelos comerciales de frontera requieren grandes cantidades de electricidad. Algunos centros de datos utilizan evaporación de agua para refrigeración y su instalación puede reducir la disponibilidad local de agua dulce. El impacto depende del hardware, la duración, la fuente de energía, el sistema de enfriamiento y la ubicación; no es una propiedad idéntica de todos los modelos.
Tiyat opera en otra escala. Su entrenamiento requiere una fracción mínima del cómputo utilizado por un modelo frontera y, como referencia preliminar, puede situarse en el orden del consumo eléctrico de un electrodoméstico de alta demanda funcionando durante un par de días. Publicaremos la medición de hardware, tiempo y energía de cada corrida en el informe técnico, porque una equivalencia aproximada no sustituye datos verificables.
El costo de inferencia también es considerablemente menor. Esta eficiencia facilita experimentar con infraestructura accesible y avanzar hacia modelos que puedan ejecutarse localmente, sin asumir que todo desarrollo de IA requiere un centro de datos de escala comercial.
Derechos lingüísticos y soberanía tecnológica
La creación de Inteligencia Artificial en lenguas originarias de México es un paso esencial para la soberanía tecnológica y la justicia lingüística. Conforme estas tecnologías adquieren mayor presencia, dejar fuera a una lengua también significa dejar fuera a sus hablantes de nuevas formas de acceso, creación y participación. Este derecho a existir en el espacio digital ha sido defendido durante años por comunidades y activistas; Tiyat busca aportar una herramienta concreta para hacerlo efectivo.
Para Tachiwin, desarrollar estas tecnologías no representa un riesgo que deba evitarse, sino una oportunidad que debe construirse con responsabilidad y bajo control comunitario. El problema no es que una lengua cuente con herramientas de IA, sino que sus textos y conocimientos sean extraídos para crear productos cerrados sobre los cuales sus comunidades no tengan voz, acceso ni capacidad de decisión.
Tachiwin es una iniciativa indígena, mexicana, comunitaria y sin fines de lucro. No vendemos los contenidos reunidos por el proyecto ni los entregamos a empresas transnacionales para su privatización o incorporación a modelos de fuente cerrada. Nuestro trabajo se publica con licencias abiertas para que las comunidades puedan utilizarlo, estudiarlo, reproducirlo y transformarlo sin depender del permiso o de los intereses comerciales de una plataforma privada.
Esa es la diferencia entre estar representados dentro de una tecnología ajena y ejercer soberanía tecnológica: no ser únicamente fuente de datos o personas usuarias finales, sino contar con los conocimientos y recursos necesarios para construir tecnología propia. Consideramos Tiyat un bien tecnológico abierto al servicio de las comunidades y una base para que nuevos proyectos puedan surgir desde sus propias lenguas, necesidades y decisiones.
Próximos pasos
Los resultados actuales permiten continuar en cuatro líneas:
- ampliar y documentar el corpus, especialmente en las variantes con menor representación;
- continuar el preentrenamiento para aprovechar la capacidad todavía disponible en la arquitectura;
- construir evaluaciones por lengua y familia, con participación de hablantes;
- añadir etapas posteriores para seguir instrucciones, conversar, traducir y utilizar herramientas digitales.
El horizonte de Tachiwin es crear una IA capaz de identificar, traducir y conversar en las 68 lenguas originarias de México y sus variantes. Tiyat todavía no ofrece esas capacidades completas; valida los componentes fundamentales para seguir avanzando hacia ellas.
Próximamente publicaremos un informe técnico con la composición detallada del corpus, evaluaciones de tokenización, curvas de entrenamiento, resultados por lengua y mediciones de consumo computacional. Los pesos y cuadernos de esta primera versión permiten que el proceso pueda revisarse y reproducirse desde ahora.
- Prueba Tiyat en Hugging Face: Tiyat Nano
- Prueba Tiyat en ModelScope: Tiyat Nano
- Modelo y recursos: Modelo en Huggingface
- Notebooks Abiertos: Tutorial de entrenamiento de Tiyat
Una tierra construida en memoria
Tachiwin es un sueño continuado por personas y activistas que lucharon por hacerlo posible y que ya no están aquí para ver estos resultados. También se construye en memoria de los saberes, lenguas y pueblos que se perdieron en el camino.
Continuamos este trabajo en memoria de nuestro fundador, Fidencio Hernández Hernández (1990–2025).
Wix klakgapastakgan kin xkuti.
Ayúdanos a continuar
Tachiwin es una iniciativa indígena, mexicana, comunitaria, de código abierto y sin fines de lucro. Digitalizar nuevos acervos, entrenar modelos y evaluar cientos de variantes requiere tiempo, infraestructura y colaboración.
Si quieres ayudarnos a cultivar esta tierra, puedes hacer una donación en:
Gracias por ayudar a que las lenguas originarias trasciendan a través de la tecnología.